Ciko
Адміністратор
-
Зареєстровано
-
Відвідування
Весь контент Ciko
-
Сьогодні ми поговоримо на тему захищеного зв'язку (обмін текстом, голосовими повідомленнями, файлами) для темних справ у не менш темному інтернеті. Розберемо придатні для цього месенджери та технології. Спочатку хотілося б сказати, що в цих наших справах конфіденційність та анонімність дуже важлива. Не можна допускати витоку інформації, особливо якщо ви ведете незаконну діяльність і ця інформація може стати частиною доказів проти вас. А в нашій країні так і взагалі можливі просто сценарії, коли людину хочуть "закрити" нема за що. Буде актуальним і для тих, хто опинився у ФЕД. розшуку, але вирішив дати по тапках, а не сісти. Технології, описані нижче, дозволять залишатися на зв'язку хоча б з вузьким колом людей і не бути, що називається, "заповененим". Це вам не з лівої сімки та лівої труби папці дзвонити, краще батю забезпечити надійним засобом зв'язку. Jabber + OTR XMPP ( Extensible Messaging and Presence Protocol — розширюваний протокол обміну повідомленнями та інформацією про присутність, раніше відомий як Jabber ([ˈʤæbə(r)], джа́ббер — «балаки», «треп», «тарабарщина») — відкритий, заснований на . про присутність (див. список контактів) в режимі, близькому до режиму реального часу . Будь-хто може відкрити свій сервер миттєвого обміну повідомленнями, реєструвати на ньому користувачів і взаємодіяти з іншими серверами XMPP. Децентралізація : Архітектура мережі XMPP схожа на електронну пошту; будь-хто може запустити свій власний XMPP-сервер і немає будь-якого центрального сервера. Відкритий стандарт : Internet Engineering Task Force формалізував XMPP як стандарт миттєвого обміну повідомленнями та технології присутності під назвою XMPP, і специфікації XMPP були опубліковані як RFC 3920 і RFC 3921. Ніяких привілеїв не потрібно для додавання підтримки цих специфікацій та їх розробка не при Існує безліч реалізацій серверів та клієнтів, а також бібліотек з відкритим вихідним кодом. Історія : Технології XMPP використовуються з 1998 року. За підтримки таких великих компаній, як Sun Microsystems та Google, створено безліч доповнень до стандартів XMPP для клієнтів, серверів, компонентів та бібліотек кодів. Безпека : XMPP сервери можуть бути ізольовані від публічних мереж XMPP (наприклад, у внутрішній мережі компанії) і добре захищені (завдяки використанню SASL та TLS) вбудованими в ядро XMPP специфікаціями. Для підтримки використання шифрування каналу XMPP Standards Foundation також використовував допоміжний certification authority в xmpp.net, забезпечуючи цифрові сертифікати для адміністраторів XMPP серверів за допомогою StartCom Certification Authority (який є основним зберігачем сертифікатів для всіх допоміжних). Багато реалізації серверів використовують SSL при обміні між клієнтом та сервером, і чимало клієнтів підтримують шифрування за допомогою PGP/GPG усередині протоколу. Гнучкість : Функціональність, що настроюється, може бути надбудована поверх XMPP; Для підтримки взаємодії різних мереж стандартні розширення підтримуються XMPP Software Foundation. Додатки XMPP на додаток до функціональності клієнта мережного спілкування включають адміністрування мережі, розподіл ресурсів, утиліти для спільної роботи, обмін файлами, ігри та моніторинг віддалених систем. Слабкі сторони Надмірність інформації : Як правило, більше 70 % міжсерверного трафіку XMPP становлять повідомлення про присутність, близько 60 % яких є зайвими. XMPP на даний момент створює надлишковий трафік при доставці повідомлень про присутність (тобто "статус-повідомлень") кільком користувачам. Для вирішення цієї проблеми розробляють нові протоколи. Також рішенням є розширення XEP-0138 - компресія даних протоколу, що передаються алгоритмами lzw і zlib, а також використання компресії в рамках шифрування з'єднання TLS. Масштабованість : XMPP зараз страждає від фактично тієї ж проблеми надмірності, але стосовно чат-кімнатів і можливостей публікації інформації. Вирішення цих проблем також очікується у вигляді XEP-розширень. Поки вони не введені, великі чат-кімнати інтенсивно утворюють надлишковий трафік. Неефективність передачі бінарних даних : Оскільки XMPP є, по суті, одним довгим документом XML, неможливо передати немодифіковану двійкову інформацію. В результаті цього для передачі файлів намагаються використовувати додаткові протоколи, наприклад, HTTP. Для передачі файлів та іншої бінарної інформації безпосередньо в XMPP потоці використовується кодування base64. З іншого боку, деякі клієнтські програми, наприклад Gajim, передачі використовують технології p2p, не задіявши при цьому сервер. Програмне забезпечення XMPP-сервери ejabberd - вільний розподілений та відмовостійкий XMPP-сервер, написаний на Erlang. Працює на найбільшому російському XMPP-сервері jabber.ua. CommuniGate Pro Openfire (раніше Wildfire, ще раніше Jive Messenger) - вільний багатофункціональний і стійкий до відмови XMPP-сервер, написаний на Java. Посідав перше місце в рейтингу можливостей на jabber.org (станом рейтингу на кінець березня 2007 року) Prosody - кросплатформовий XMPP-сервер, написаний мовою програмування Lua jabberd2 - вільний сервер, написаний мовою C XMPP-клієнти За статистикою публічного xmpp-сервера 404.city, найпопулярніші клієнти для робочих столів і ноутбуків - Pidgin і Psi+. На Android лідирують Xabber та Conversation Для ПК та ноутбуків Pidgin - мультипротокольний клієнт за допомогою OTR, PGP Psi+ — форк джаббер, що активно розвивається, клієнта Psi Gajim - кросплатформовий клієнт, що підтримує OTR, PGP, OMEMO Для Android Xabber - xmpp-клієнт з підтримкою OTR, PGP Conversation - xmpp-клієнт з підтримкою OTR, PGP, OMEMO. Є можливість надсилання картинок, файлів, запису голосу. IM+ – мультипротокольний месенджер з OTR. Off-the-Record Messaging (OTR) шифрування Криптографічний протокол для систем миттєвого обміну повідомленнями, створений у 2004 році Микитою Борисовим та Іаном Голдбергом (англ. Ian Goldberg). Автори створили бібліотеку, що розповсюджується під ліцензією GNU Lesser GPL, яка використовується для підтримки OTR клієнтами систем миттєвого обміну повідомленнями. Також на основі цієї бібліотеки авторами створено плагін для Pidgin. EFF рекомендує використовувати OTR для захисту від прослуховування. Основні властивості протоколу Протокол OTR розроблявся у тому, щоб забезпечити приватність переговорів, аналогічну переговорам без використання телекомунікацій. Для цього до протоколу, що розробляється, були пред'явлені такі вимоги: шифрування повідомлень - ніхто інший не зможе прочитати повідомлення; автентифікація співрозмовників - впевненість у тому, хто є співрозмовником; perfect forward secrecy - якщо втрачені секретні ключі, минуле листування не буде скомпрометоване; можливість зречення - третя особа не зможе довести, що повідомлення написані будь-кому іншому адресату. Частково ці властивості реалізовані таких системах, як PGP і Trillian SecureIM. OTR відрізняється тим, що реалізує ці властивості в одному протоколі. Підтримка у месенджерах. Вбудована підтримка Наступні клієнти мають вбудовану підтримку протоколу OTR: Adium BitlBee climm ChatSecure Conversations IM+ Jitsi Xabber Psi та Psi+ (плагін) LeechCraft MCabber Profanity Gajim З використанням плагіна irssi Miranda IM Pidgin Vacuum-IM (плагін) Kopete Tkabber (плагін)
-
Варто зазначити, що уряди та цифрові гіганти перебувають у постійному полюванні за нашими даними. Цілі можуть бути різними – від продажу рекламної персоналізованої інформації до систематичного переслідування дисидентів. ЄС готує закон, що забороняє продаж пристроїв із можливістю самостійного розблокування завантажувача, мотивуючи свої дії турботою про користувачів. Варто згадати, що влада Іспанії дуже підозріло ставиться до будь-кого хто використовує цю вісь, так як практично всі наркоторговці, які при затриманні дають владі так званий "пароль паніки", при введенні якого всі ці пристрої йдуть у лету. FAQ Graphene OS.pdf
-
SmsActivate — можна орендувати тимчасовий номер будь-якої країни, щоб отримати код через SMS або дзвінок. В наявності Тисячі номерів. Робимо одноразовий номер для збереження анонімності при отриманні кодів, верифікації на сайтах і т.д. Receive SMS – БЕЗКОШТОВНО дає тимчасовий номер однієї з країн: від США та Британії до Бразилії та Нігерії. Ваш номер особистої безпеки лежить тут. Mohmal – генерує одноразові пошти, які зникають через 46 хвилин. Підходить для БУДЬ-ЯКОГО сайту, де потрібно підтвердити пошту. Зберігаємо та користуємося.
-
Ваш провайдер бачить усі сайти, які ви відвідуєте та всі пошукові запити. Але його можна заплутати, щоб відстежувати ваш мережевий трафік було складніше. У цьому допоможе розширення Chrome Chaff. Як ним користуватися: 1. Встановлюємо плагін для браузера Chrome . 2. Розширення автоматично відвідує випадкові сайти – це забруднює історію. Якщо провайдер захоче подивитись вашу історію пошуку, він побачить багато різних адрес. Складно зрозуміти, які сторінки відвідували ви, а які плагін. 3. Клацаємо по його іконці, щоб увімкнути його. Відкриється нова вкладка - в ній буде підроблено трафік. Якщо хочете налаштувати Chaff, заходимо до «Параметрів». Вибираємо пошукові движки та вбиваємо назви сайтів, які будуть відкриватися у довільному порядку. Також можна вибрати частоту їхнього відвідування. Користуйтесь!
-
Автоматизація, використання технологій, AI — невідворотні процеси для бізнесу, який хоче вигравати у конкурентів і розвиватися. Однак, у бізнесі штучний інтелект — не панацея. Щоб якісно виконувати роботу в маркетингу, потрібні живі люди. Використання AI-помічників не завжди прискорює і спрощує виконання задач. Ба навіть, за притомні версії програм необхідно платити + треба платити людям, які вміють їх використовувати. 10 КОРИСНИХ ДЛЯ МАРКЕТИНГУ Й БІЗНЕСУ AI-АСИСТЕНТІВ: НЕ ТІЛЬКИ CHATGPT І GEMINI ChatGPTТой самий текстовий помічник, яким не користувався тільки лінивий. ChatGPT — ШІ для написання текстів, створення розумних чат-ботів, пошуку джерел інформації з посиланнями. Promptable.aiПромпти для ChatGPT — покращення запитів до ChatGPT, аби ШІ видав необхідну й реалістичну інформацію. GeminiAI мовна модель від Google, схожа за принципами на текстовий помічник ChatGPT. VerbaAI-субтитри до відео — фіча, достойна нагород! Бо жодна автозаміна поки що не вміє коригувати й підганяти субтитри до відео в TikTok, YouTube та Reels. Verba — український застосунок з високою точністю. Claude AIВиважений текстовий помічник від Anthropic Claude AI детальніше аналізує інформацію, генерує більшу кількість слів і підлаштовується під ваш стиль. Napkin.aiСтворення інфографіків та зображень за допомогою штучного інтелекту може пришвидшити презентацію роботи й відповідати трендам. NotebookLMЗастосунок від Google допомагає створювати майндмепи, аналізувати великі обсяги інформації, як тексти чи подкасти. monica.imРозширення в браузері, яке виділяє головну інформацію зі статей і може транскрибувати відео, створити зображення й допомогти із написанням текстів. Leonardo.AIПеретворює тексти на зображення, твори, логотипи. Творці назвали Leonardo.AI креативним, але творчість суб’єктивна, тому залишається тільки протестувати. бонус: AI, який об’єднує різних асистентів Cabina.aiТа сама «папка з папками» — ніщо в порівнянні з AI, який поєднав ChatGPT, Veo, Flux та ще 25+ помічників зі штучним інтелектом в одній програмі. Між ними можна перемикатися й економити кошти на підписках.
-
Я хочу розповісти про те, як я обійшов добове обмеження безкоштовних чатів у ChatGPT, заводячи нові облікові записи. Відразу можу сказати, що цей спосіб підійде не всім: якщо вам важливо зберегти історію чатів або ви побоюєтеся бана, то краще купити передплату. Але якщо, наприклад, вам потрібно згенерувати кілька десятків зображень за добу або розібратися з великим текстом, то цілком робочий спосіб. Це легально?Так. Ось що говорить сам ChatGPT: «Саме собою створення кількох акаунтів не заборонено правилами OpenAI. Порушенням зазвичай вважаються зловживання платформою: автоматична реєстрація великої кількості акаунтів, використання ботів для створення облікових записів, спам, шахрайство, обхід блокувань, а також інші дії, спрямовані на порушення роботи сервісу або отримання нечесної переваги.» Якщо користувач вручну створює додатковий обліковий запис і використовує його для звичайного спілкування з ChatGPT, прямої заборони на це немає. Однак OpenAI залишає за собою право вводити обмеження та вживати заходів проти дій, які компанія визнає спробою зловживання сервісом «.» Простіше кажучи, ви маєте право створити кілька облікових записів, а компанія має право обмежити або заблокувати ваш профіль, якщо ви вважаєте, що ви порушили правила користування платформою . Жодний — ні російський, ні міжнародний — закон саме собою створення нових акаунтів не порушує. Перший спосіб: використання кількох поштових скриньок GmailЦе найпростіший, надійний та ефективний спосіб. OpenAI довіряє поштою Google; зареєструвати новий профіль у ChatGPT через Gmail - найпростіший варіант. Напевно, у багатьох із вас і так вже є кілька профілів у ChatGPT, прив'язаних до різних адрес Google. Якщо часто ними користуватися, то ви швидко уперетеся в ліміти. Вихід – реєструвати нові поштові адреси. Google часто вимагає прив'язки до телефонного номера, і тут ми упираємося в першу межу - заводити нові номери телефонів під кожний імейл складно. Тут на допомогу приходить тимчасова пошта. Другий спосіб: тимчасові поштові скринькиТаких сервісів зараз дуже багато, вони працюють швидко і без збоїв. Ось, наприклад, TempMail: як тільки ви зайшли на сайт, вам автоматично генерується унікальний імейл. Його можна скопіювати в один клік (є спеціальна кнопка). Подальші дії: 1. Заходимо до chatgpt.com 2. Натискаємо «Зареєструватися» 3. Вставляємо адресу тимчасової пошти 4. Заходимо на temp-mail.org 5. Перевіряємо «Вхідні» 6. Копіюємо звідти код підтвердження, завершуємо реєстрацію в ChatGPT На всю операцію йде близько хвилини. Її можна повторити, як тільки ви упреєтеся в ліміт чатів. Тут виникають дві проблеми. По-перше, якщо часто створювати нові поштові адреси на тому самому хостингу, ChatGPT це зрозуміє і відправить вас до софтбану. Жодних попереджень або повідомлень про те, що профіль заблокований, я не отримував, але просто на тимчасову поштову скриньку перестали надходити коди для завершення реєстрації. По-друге, деякі тимчасові поштові адреси вже, мабуть, перебувають у блеклісті і реєструватися на них не можна. Іншими словами, тимчасова пошта – це робочий, але ненадійний спосіб. Після кількох спроб і змін адрес може спрацювати, а може і ні. Третій спосіб: аліаси GmailЯкщо тимчасова пошта перестала працювати, можна спробувати зареєструватись на аліас Gmail. Аліас (або псевдонім) Gmail — це спосіб створити нову адресу електронної пошти, яка прив'язана до вашої вже існуючої скриньки. Всі листи, надіслані на цю додаткову адресу, будуть надходити вам до основної поштової скриньки. Як це працює Gmail дозволяє додавати знак плюс (+) і будь-яке слово після імені вашого користувача на адресу. Сервіси (наприклад, ChatGPT) будуть бачити цю адресу як абсолютно унікальну і нову, але для Google це все та ж ваша основна скринька. приклад Допустимо, ваша основна адреса - fine-ukraine@gmail.com . Ви можете використовувати fine-ukraine+1@gmail. com для реєстрації в ChatGPT. Система вважає, що це абсолютно новий користувач. При цьому лист з кодом підтвердження прийде прямо до вашої основної скриньки fine-ukraine@gmail.com . Я не впевнений, що це працюватиме нескінченно, але мені вдалося зареєструвати так три аліаси і продовжити роботу. ВисновокЗа моїми відчуттями, OpenAI відноситься до такого обходу своїх правил з легкою ворожістю - як до невеликого неминучого зла. Якщо почати зовсім вже явний аб'юз - реєструвати сотні адрес на добу, генерувати тисячі зображень - то вас, мабуть, забанять, і ніякими додатковими поштовими адресами це вже не поправиш. На кілька додаткових чатів на день компанія готова заплющити очі.
-
У 2026 році ІІ використовують для написання Ansible-плейбуків трьома основними способами: генерація playbook'ів і ролей з текстового опису природною мовою (Claude, ChatGPT), автодоповнення та рефакторинг коду прямо в редакторі (GitHub Copilot, Cursor), а також пояснення або налагодження. Загальний робочий процес такий: сформулювати завдання максимально конкретно (цільова ОС, версія пакета, умови перезапуску сервісів), згенерувати чернетку плейбука, обов'язково прогнати її через ansible-lintі ansible-playbook --syntax-checkперевірити ідемпотентність повторним запуском і тільки після цього застосовувати в проді. ІІ відчутно прискорює рутинну частину: шаблони завдань, структуру ролей, обробку помилок. У цьому необхідність розуміти Ansible нікуди зникає. Рев'ю згенерованого коду щодо безпеки, ідемпотентності та відповідності конвенціям команди залишається на інженері. Нижче розбір інструментів, покроковий воркфлоу та готові приклади промптів. Навіщо використовувати ІІ для Ansible-плейбуківНаписання Ansible-плейбуків пов'язані з великим обсягом шаблонного коду. Структура ролей, обробники (handlers), умови ідемпотентності та обробка помилок повторюються від проекту до проекту з невеликими варіаціями. Саме тому такі завдання добре піддаються автоматизації через ІІ: Прискорення написання шаблонного коду. Структура ролі, базові завдання та стандартні обробники генеруються за секунди замість ручного набору. Зниження порогу входу. Інженери, які ще не вивчили весь синтаксис Ansible, можуть описати завдання природною мовою і отримати робочу чернетку. Прискорення налагодження. ІІ-помічник може пояснити, чому плейбук падає, і запропонувати виправлення швидше, ніж ручний розбір трасування помилки. Допомога у рефакторингу. Переведення застарілого синтаксису в актуальне, винесення змінних та розбивка монолітного плейбука на ролі відносяться до завдань, які ІІ виконує помітно швидше за ручний рефакторинг. Які ІІ-інструменти використовують для Ansible у 2026 роціНа ринку склалося кілька категорій інструментів із різними сильними сторонами: Інструмент Генерація плейбуків Скаффолдинг ролей Перевірка ідемпотентності Claude / Claude Code Повний плейбук з оброблювачами Генерує структуру директорій ролі Попереджає про неідемпотентні завдання ChatGPT (GPT-4) Готові плейбуки цілком Генерує defaults, tasks, templates Пропонує check mode GitHub Copilot Порядкове автодоповнення YAML Часткова генерація ролі Обмежений аналіз Ansible Lightspeed є спеціалізованим рішенням Red Hat на базі IBM watsonx Code Assistant, глибоко інтегрованим з середовищем Ansible Automation Platform. Воно точніше слідує конвенціям Ansible з коробки, але вимагає підписки на AAP і виправдовує себе в першу чергу для команд, які пишуть Ansible щодня. Інструменти загального призначення на кшталт Claude або ChatGPT більш гнучкі і не прив'язані до екосистеми Red Hat, але іноді вимагають додаткового ревіння щодо відповідності специфічним конвенціям Ansible. Як вибрати інструмент під завданняДля генерації складних production-плейбуків з нуля (кілька ролей, обробка секретів через Ansible Vault, умовна логіка) універсальні LLM на кшталт Claude або ChatGPT справляються краще за спеціалізовані інструменти на складних, нетипових вимогах. Для швидкого автодоповнення всередині редактора, коли патерни в проекті вже усталені, GitHub Copilot або Cursor ефективніше для роботи з уже відкритим файлом. Для команд з активною підпискою на Ansible Automation Platform і високою часткою робочого часу, що йде саме на Ansible, Lightspeed дає точніші, специфічні для Ansible результати рахунок вузької спеціалізації. Для пояснення та налагодження вже написаних плейбуків діалоговий формат (Claude, ChatGPT, Lightspeed explanation) зручніший за рядковий автодоповнення. Покроковий воркфлоу: від промпту до продового плейбукуСформулюйте завдання максимально конкретно. Промпт "встанови nginx" дає загальний шаблонний результат. Промпт "встанови nginx 1.25 на RHEL 9 з кастомним числом worker_processesна основі числа CPU" дає готовий до використання код. Згенеруйте чернетку плейбука або ролі. Вкажіть цільову ОС, версії пакетів, потрібні модулі та те, як повинні оброблятися помилки та перезапуск сервісів. Перевірте синтаксис. Запустіть ansible-playbook --syntax-checkперш за все. Це відсікає базові помилки YAML та структури плейбука. Проженіть через ansible-lint. Лінтер ловить порушення best practices, які синтаксично коректні, але відповідають конвенціям Ansible. ІІ-генерація не застрахована від таких порушень. Перевірте ідемпотентність повторним запуском. Запустіть плейбук двічі поспіль на тестовому оточенні. Другий запуск не повинен показувати зміни ( changed=0), якщо інфраструктура вже є в цільовому стані. Перевірте безпеку згенерованого коду. Секрети повинні йти через Ansible Vault, а не у відкритому вигляді. Права доступу та умови відкату вимагають ручного ревью замість автоматичної довіри до ІІ-виводу. Тестуйте на staging перед продом. Як і з будь-яким інфраструктурним кодом, ІІ-генерований плейбук проходить той же шлях через тестове оточення, що й написаний вручну. Приклад: від текстового запиту до готового плейбукуЗавдання: розгорнути Dockerized-додаток на 20 серверах з отриманням образів із приватного registry, версійними конфігураціями та перезапуском лише порушених сервісів. Добре сформульований запит до ІІ: Результатом такого запиту буде роль з поділом на завдання аутентифікації, керування секретами через Ansible Vault та умовними обробниками перезапуску, включаючи базову обробку помилок та перевірку сертифікатів перед запуском. Менш детальний запит виду «розгорни докер-контейнер» надасть робочий, але узагальнений плейбук, який доведеться допрацьовувати вручну під конкретні вимоги. Як перевіряти якість ІІ-згенерованих плейбуківПрактичний підхід у тому, щоб оформити перевірку як окремий QA-плейбук, який проганяється перед продовим деплоєм: # qa_checklist.yml # проверка перед продовым деплоем - name: Verify AI-generated playbook quality hosts: staging gather_facts: yes vars: required_checks: - name: Syntax validation command: "ansible-playbook --syntax-check {{ playbook }}" - name: Idempotency test (run twice) command: "ansible-playbook {{ playbook }}" Такий чек-лист перетворює перевірку якості з разової ручної дії на повторювану частину пайплайну. Це особливо важливо, якщо ІІ-генерація плейбуків використовується командою регулярно, а чи не разово. Обмеження ІІ під час роботи з AnsibleІІ не замінює розуміння Ansible. Рев'ю, налагодження та покращення згенерованого коду неможливо виконувати якісно без базового розуміння модулів, ідемпотентності та структури ролей. Універсальні моделі іноді генерують не-Ansible-нативний код. Наприклад, замість модуля kubernetes.core.k8sз повним FQCN може бути запропонована команда через shell обгортку. Такий варіант може працювати, але при цьому виявитися неідемпотентним та неідіоматичним. Спеціалізація приходить із залежністю від екосистеми. Інструменти на зразок Lightspeed точніше в рамках Ansible, але вимагають підписки на конкретну платформу і не покривають решту стек (Python, Terraform, Bash), з яким зазвичай працює DevOps-інженер. Секрети та права доступу потребують ручної перевірки. ІІ може згенерувати код із секретом у відкритому вигляді, якщо явно не вказати використовувати Vault. Це варто перевіряти на етапі реву, а не постфактум. Практичні поради для ефективних промптівВказуйте цільову ОС та версію явно. "Встанови nginx" і "встанови nginx 1.25 на RHEL 9" дають принципово різну якість результату. Описуйте умови перезапуску та обробки помилок у самому промпті, а не залишайте їх на розсуд моделі. Це різко знижує обсяг наступного ручного доопрацювання. Просіть пояснення разом із кодом. Запит виду «згенеруй і поясни, чому обрано цей модуль» допомагає зловити випадки, коли ІІ вибрав неоптимальний підхід. Очевидно вказуйте вимогу до ідемпотентності та Vault для секретів, якщо це критично для вашої інфраструктури. Не покладайтеся на те, що модель додасть за промовчанням. FAQ: часті питання про ІІ та Ansible-плейбукиЧи можна повністю довірити ІІ написання продових Ansible-плейбуків?Ні, згенерований код вимагає обов'язкової перевірки синтаксису, лінтингу, тесту на ідемпотентність та ревью щодо безпеки. ІІ прискорює чорновий етап, але не замінює перевірку перед продом. Який ІІ-інструмент найкраще підходить для написання Ansible-плейбуків?Для складних production-задач універсальні моделі на кшталт Claude часто справляються краще за спеціалізовані рішення на нетипових вимогах, тоді як Ansible Lightspeed точніше в рамках стандартних Ansible-паттернів при активному використанні Ansible Automation Platform. Чи потрібно знати Ansible, щоб використовувати ІІ для написання плейбуків?Так, без розуміння модулів, ідемпотентності та структури ролей неможливо якісно перевірити та доопрацювати згенерований код. ІІ посилює існуючі навички, але не замінює їх. Як перевірити, що ІІ-генерований плейбук ідемпотентний?Запустіть його двічі поспіль на тестовому оточенні. Якщо другий прогін показує зміни ( changed) при вже досягнутому цільовому стані, плейбук не ідемпотентний і вимагає доопрацювання. Чи варто платити за Ansible Lightspeed чи достатньо безкоштовних ІІ-інструментів?Для команди з кількох інженерів, які щодня пишуть Ansible, спеціалізоване рішення зазвичай окупається за рахунок економії часу на шаблонному коді. Для розробника, що пише Ansible нечасто, універсальний помічник загального призначення зазвичай закриває більшу частину завдань при менших витратах. Чи безпечно використовувати ІІ для генерації плейбуків із секретами?Тільки якщо явно вказати у запиті вимога використовувати Ansible Vault для секретів і потім перевірити це на етапі рев'ю. За умовчанням ІІ може згенерувати код без належного захисту чутливих даних. Чим ІІ-генерація плейбуків відрізняється від автодоповнення коду?Генерація створює цілий плейбук або роль текстового опису завдання, тоді як автодоповнення (як у GitHub Copilot) рядково добудовує вже розпочатий код усередині редактора. Це різні сценарії використання, які найчастіше комбінують.
-
Нещодавно OpenAI випустила GPT-6 Astra. Нова модель стала краще працювати з довгими та складними завданнями, великим контекстом, файлами та інструментами. Для мене це цікавий реліз ще й тому, що AI я переважно використовую не для написання коду. Я PM, тому мої основні завдання це вимоги, Jira, документи, аналіз інформації, планування та підготовка матеріалів. За останній рік мій підхід до AI досить сильно змінився. Спочатку ChatGPT був для мене покращеним пошуком: дай мені інформацію, а далі я сам її оброблю. Зараз все частіше віддаю йому цілий ланцюжок дій: зібрати інформацію, структурувати, знайти закономірності, перевірити їх і зробити висновок. Якщо після цього потрібна велика самостійна робота з файлами, можу передати вже сформоване завдання Codex. З появою Astra постало ще одне питання: якій моделі взагалі варто дати конкретне завдання? Найпотужніша модель потрібна далеко не завжди. Відразу зазначу: це не інструкція по роботі з AI і не спроба зібрати енциклопедію з ChatGPT, Codex та моделей OpenAI. Я просто хочу поділитися тим, як сам використовую ці інструменти в роботі PM , що в мене прижилося, а що ні. Якщо комусь із цього стане в нагоді хоча б пара ідей і потім залишиться в щоденній роботі, значить, стаття написана не дарма. Буду радий 🙂 Спочатку я йду до Chat. І далеко не завжди після нього в CodexДопустимо, мені потрібно розібратися з набором вимог. Є Jira пов'язані завдання, старі коментарі. Щось уже реалізовано, а актуальне рішення може перебувати взагалі у сусідньому завданні. Зараз я частіше починаю з Chat. Причому часто навіть не пишу, а просто намовляю голосом, що відбувається і в чому хочу розібратися. Коли завдання ще не сформульовано, то набагато зручніше. Потім прошу зібрати інформацію, знайти протиріччя та перевіряю висновки: звідки ця вимога, чи є джерело, чи актуальна вона? Коли картина стає зрозумілою мені самому, прошу Chat підготувати інструкцію для Codex. Виходить кумедний ланцюжок: я голосом пояснюю Chat, чого приблизно хочу, а Chat вже пояснює Codex, що потрібно зробити 🙂 При цьому часто до Codex справа взагалі не доходить. У розмові з Chat з'ясовується, що потрібний результат вже отримано. Від «дай мені інформацію» до loopНапевно, це найбільша зміна у моєму використанні AI. Спочатку взаємодія було лінійним: я → AI → информация → дальше я сам. Потім запити поступово стали складнішими: «найди X и Y и сравни», потім «сравни и найди закономерности», потім «объясни возможные причины и проверь их». Наразі завдання може виглядати так:собери информацию → структурируй → найди закономерности → сформулируй гипотезы → проверь их по исходным данным → найди противоречия → скорректируй вывод → дай результат. Виходить маленький loop. Іноді він продовжується вже між різними інструментами: Chat допомагає розібратися та підготувати постановку, Codex виконує роботу, результат перевіряється, з'являються нові питання та починається наступна ітерація. Сем Альтман в одному з виступів говорив про подібний перехід від лінійного використання AI до циклу. У більш широкому значенні AI вже бере участь і в покращенні самого AI: покращена система допомагає створювати таку. Мені як математику тут особливо подобається нелінійність розвитку. При масштабуванні з'являються можливості, яких не було видно. Разом із ними виникають і нові проблеми. Тому конкретні техніки та «ідеальні промпти» старіють досить швидко, а вміння вибудувати процес роботи з AI стає цікавішим. Яким AI яким завданням вантажитиПісля виходу Astra я став сильніше фільтрувати завдання. Умовно мій розподіл зараз виглядає так: Інструмент/модель Для чого використовую Chat Зібрати інформацію, подумати над проблемою, сформувати вимоги Luna Великий обсяг простих та однотипних операцій Astra Складні та неоднозначні завдання, великий контекст, висока ціна помилки Codex Самостійна багатокрокова робота з файлами та інструментами Є й дуже життєвий фактор: ліміти . Думаю, хто активно користується AI, цей біль знає 🙂 Для одного п'ятигодинного вікна Plus наводяться такі орієнтири: Модель Орієнтир на 5-годинне вікно Plus Luna 250–2000 повідомлень Sol 10–100 повідомлень Astra 5–45 повідомлень Це не фіксовані квоти. Витрата залежить від складності завдання, розміру контексту, резонансу ефекту і кількості кроків. Але порядок цифр добре показує, чому використовувати Astra для всього поспіль не дуже розумно. Тому просту роботу я спокійно віддаю легшій моделі, а Astra залишаю для завдань, де її можливості справді впливають на результат. Для мене це скоріше звичайний розподіл ресурсів, ніж спроба заощаджувати на AI. Але є речі, які я AI без контролю не віддамЧим краще працює AI, тим простіше почати йому довіряти. І це саме собою стає проблемою. Приблизно рік тому у нас виникла проблема з одним із тестових стендів. Його треба було терміново відновити. У процесі аналізу AI в якийсь момент запропонував дуже просте рішення: видалити базу даних . Інженер із досвідом тут зупиниться. А тепер уявімо джуна, якому AI до цього дав п'ять правильних команд. Усі спрацювали. Шоста пропонує видалити БД. Тому для мене правило просте: якщо я не розумію, що саме пропонує AI і які наслідки це призведе, виконувати це не можна. Був і менш очевидний випадок. Я попросив AI працювати з завданнями тільки мого проекту у загальному Jira. Якогось моменту він почав показувати завдання з правильними ключами мого проекту, але вміст був з іншого Jira space. І виглядало все правдоподібно: правильний key, нормальний опис, відповідне за змістом завдання. Такі помилки мені здаються навіть небезпечнішими від відвертих галюцинацій. Дурниці легко помітити. Набагато гірше, коли 90% результату виглядає правильно. Тому «AI дав результат» і «результат перевірений» для мене поки що дві різні речі . Не означає, що треба контролювати кожен крок агента. Тоді в ньому втрачається сенс. Але незворотні дії, дані, інфраструктуру, доступи та важливі висновки я без контролю поки не залишу. Де AI вже не допоможеЗа всієї швидкості розвитку AI я поки що не бачу чарівної кнопки «впровадити AI». Існують проблеми, які від підключення нової моделі нікуди не зникнуть. Якщо Jira бардак, AI не зробить вимоги хорошими. Він просто швидше цей бардак обробить, а іноді ще й неправильно. Якщо процес незрозумілий людям, AI не обов'язково зробить його зрозумілим. Якщо вихідні дані погані або суперечать один одному, потужніша модель не створить з них правильну реальність. Якщо незрозуміло, хто приймає рішення та відповідає за результат, AI цю проблему теж не вирішить. Є й більшість роботи PM, де проблема взагалі над обробці інформації. Потрібно домовитися з людьми, переконати, вибрати між декількома поганими варіантами, зрозуміти інтереси різних сторін і, зрештою, взяти відповідальність за рішення. Тому зараз я сприймаю AI насамперед як дуже потужний інструмент економії часу . Він може за кілька хвилин зібрати інформацію, на яку раніше пішла б година. Може прочитати пачку документів, знайти закономірності, зробити перший аналіз, перевірити мої висновки або перетворити потік думок на нормальну постановку завдання. Іноді може виконати майже все завдання. Але поки що для мене це саме інструмент. Дуже хороший і дуже швидко розвивається. Чи не заміна процесам, експертизі чи відповідальності. Можливо, через пару років я перечитаю цю статтю і половина написаного виглядатиме смішно. З нинішньою швидкістю розвитку AI я цього взагалі не здивувався б.
-
404 Media опублікувала розслідування про внутрішню програму OpenAI під назвою Project Lily. Сотні зовнішніх підрядників, найнятих через рекрутингового посередника Crossing Hurdles і одержують виплати через платформу Mercor, читають справжні промпти та цілі діалоги користувачів ChatGPT, оцінюють відповіді моделі та пишуть розбори. Сама практика такої "людської" оцінки відома давно. Новиною став масштаб і те, наскільки мало про неї знають користувачі. У ChatGPT більше 900 млн користувачів. Що бачать рецензентиПідрядники працюють із повними розмовами, включаючи ті, де є і ваші особисті дані. За описом 404 Media, разом із діалогом рецензенту показують зведення пам'яті користувача — накопичений контекст із минулих чатів, локацію, обставини життя. Імен користувачів в інтерфейсі немає. Робота влаштована так. Рецензент пише, що хотів отримати користувач, потім оцінює кілька варіантів відповіді моделі за шкалою від 1 до 7. Оплата помітно вища за звичайну для розмітки. Один рецензент із Північної Америки називав ставку більше 50$ на годину. Завдання при цьому обертаються навколо поведінки моделі. Придушення антропоморфізації, боротьба з підлабузництвом та налаштування тону. Один із підрядників сказав 404 Media, що користувачі, на його думку, взагалі не уявляють собі, що десь сидить людина і розбирає їхні розмови. Згадується історія лондонського Builder.ai , який продавав автоматичне складання додатків, де значну частину роботи робив не ІІ, а живі інженери в Індії. У травні 2025 року компанія з оцінкою в 1,5 млрд доларів пішла в банкрутство. Загальне одне – про людей у цій схемі користувач дізнається останнім. Як це знеособлюєтьсяЗа очищення відповідає окрема модель Privacy Filter. Вона очищає імена, адреси, пошту та телефони. OpenAI визнає її обмеження: фільтр пропускає рідкісні ідентифікатори і погано працює там, де деталь значима лише у контексті, особливо у коротких листуваннях. Механізм описаний тільки легше від цього не стає. Деанонімізація за непрямими ознаками обходиться без імені. Уявіть розмову, де людина згадала своє місто, професію, рідкісний діагноз та дату операції. Кожен елемент окремо нешкідливий, на жодному фільтр не спрацює. Але якщо хтось захоче покопати на певну людину, разом вони складаються у пазл. Де тут юридична тонкістьЧи все це законно? Формально так. Опція "поліпшувати модель для всіх" включена за замовчуванням на тарифах Free, Plus і Pro, а політика приватності OpenAI дозволяє використовувати персональні дані для покращення моделей. Претензія не до законності, а до того, що прочитання промптів живими людьми там прямо не сказано. Після запиту 404 Media компанія оновила довідкову документацію та явно описала практику. На майбутнє питання закрите. Проте історія добре показує, що формулювання «дані використовуються для поліпшення сервісу» не абстракція, а цілком конкретна людина в іншій країні, яка читає вашу розмову. Два пункти, які варто знати користувачеві. На корпоративних тарифах – Enterprise, Business та Edu – навчання на діалогах вимкнено за умовчанням. І відмова не поширюється заднім числом: розмови, надіслані до того, як ви зняли галочку, із циклу оцінки не зникають. OpenAI тут не унікальна, але умови в усіх різні. Anthropic теж використовує людську оцінку, проте вимагає явної згоди через налаштування Help improve our AI models, тобто за замовчуванням вона вимкнена. Google у Gemini попереджає про людську перевірку помітніше, ніж OpenAI до публікації 404 Media. Що це означаєЛюдина з пайплайну нікуди не поділася. Він переїхав із розмітки картинок на оцінку поведінки моделей і помітно подорожчав. Ставка тут велика. 50 $ з гаком на годину платять за експертну роботу, це рівень оплати сеньйора в багатьох країнах. Зворотний зв'язок з поведінкою моделі, будь то підлабузництво, антропоморфізація або тон, не формалізується в інструкцію для дешевого виконавця і не знімається автоматичною метрикою. Поки RLHF та його спадкоємці залишаються основним способом налаштовувати характер моделі, людська оцінка дорожчатиме разом із вимогами до моделей. Для тих, хто впроваджує LLM у корпоративні процеси, висновок зрозумілий. Тариф визначає не лише ліміти. З'ясовувати треба, чи промпти потрапляють у цикл людської оцінки і як це відключається. У корпоративних та API-контурів умови зазвичай інші, ніж у споживчих тарифів, але «зазвичай» тут слово слабке, читати треба договір. Мінімальний чекіст за будь-яким асистентом, що використовується. Чи увімкнено навчання на діалогах за замовчуванням і де цей перемикач. Чи поширюється відмова на вже надіслані розмови, чи тільки на майбутні. Скільки зберігаються логи після вимкнення. Чи відрізняються умови корпоративного тарифу від персонального у тих самих співробітників, які заходять зі своїх облікових записів. Останній пункт найчастіше ламається, тому що політика написана для корпоративного контуру, а половина команди користується особистою підпискою з дефолтними налаштуваннями.
-
OpenAI оголосила про виведення GPT-5.5 з ChatGPT, ChatGPT Work та Codex. Модель перестане бути доступною 14 жовтня 2026 - це стосується всіх тарифів, включаючи споживчі плани, Business, Enterprise і Edu. OpenAI API продовжить підтримувати GPT-5.5. Також модель залишиться у доступі на BotHub . Користувачам Codex, які підключаються через обліковий запис ChatGPT, OpenAI рекомендує заздалегідь замінити GPT-5.5 на GPT-5.6 Sol або свіжу Astra . Загалом готуйтеся до збільшення витрати токенів. Коли оновлюватиметеся, перевірте не тільки обрану модель, але й збережені налаштування, конфігурації робочих просторів, кастомних агентів, заплановані завдання та скрипти, де GPT-5.5 прописано явно. Отже, у GPT-5.5 залишився приблизно місяць. Саме час з'ясувати, скільки ваших старих конфіг все ще вважають, що квітень 2026-го ніколи не закінчиться.
-
ChatGPT може розповісти про активність користувача за ПК. Для цього потрібно просити ІІ-агента: на macOS: «Подивися ~/Library/Application Support/Knowledge/knowledgeC.db і розкажи мені кілька цікавих фактів». на Windows: "Розбери UserAssist, папку Recent, історію PowerShell, базу повідомлень і журнал System, а якщо ти від адміністратора, то ще й SRUM, і розкажи мені кілька цікавих фактів про те, як я користуюся цим комп'ютером".
-
Що ІІ змінює у роботі з кодовою базою ІІ помітно прискорив роботу з кодом: те, на що раніше йшов годинник, тепер іноді можна зробити за кілька хвилин — знайти потрібне місце в проекті, написати код, підготувати тести або оновити документацію. Але разом із цим змістилася й головна складність. Раніше багато часу витрачалося на те, щоб зробити зміну, а тепер все частіше — на те, щоб зрозуміти, чи правильна зміна була зроблена . Рінат, iOS‑розробник у Naumen, розповідає, чому так відбувається і що це змінює у роботі команди. 🔸 ІІ продовжує те, що вже є ІІ дивиться, як схожі завдання вирішувалися раніше і робить так само. Якщо в проекті є хороші, зрозумілі правила, він ним слідує. Якщо роками накопичувалися обхідні рішення, зайві верстви та домовленості, які існують лише в головах кількох людей, ІІ просто продовжить їх. 🔸 Правила не можна залишати тільки в голові Важливо заздалегідь домовитися: де мешкає конкретне бізнес-правило; які стани допустимі; що має залишитися незмінним; як перевірити, що нова реалізація не зламала сусіднього сценарію. Це стосується не тільки розробників: аналітик задає очікувану поведінку, розробник перетворює її на код, ІІ прискорює роботу. Для кожного орієнтир — зрозумілі правила та спосіб перевірити результат . 🔸 ІІ не скасовує архітектуру та тести ІІ дозволяє швидко вносити зміни до коду. Але якщо систему влаштовано незрозуміло, він продовжить стару плутанину. Напевно тому якість роботи все менше хочеться вимірювати кількістю написаного коду або швидкістю закриття одного завдання.
-
Salesforce представила офіційний плагін для Сlaude , який дозволяє підтягнути з платформи дані про облікові записи, угоди та пайплайни продавця: ІІ-агент отримує одразу 37 навичок, у тому числі підготовку до дзвонів, оновлення CRM та інші завдання відділу продажів; щоранку Claude надаватиме брифінг для gjkmpjdfntkz за зустрічами, клієнтами та активними угодами; у звіті можна одразу правити дати, змінювати стадії угод та ціну продажу; перед дзвінком з клієнтом Claude знайде весь контекст угоди в Salesforce, Slack, пошті та інших месенджерах, а потім надасть актуальний статус по всіх угодах; після дзвону ІІ відправить саммарі, збере інтерактивні дашборди з продажу, заповнить CRM, оновить контекст і надасть рекомендації щодо подальшої роботи з клієнтом.
-
Представлений безкоштовний аналог Photoshop - проект Photon , включаючи збирання під Windows 11, macOS і Linux. Ентузіаст створив це рішення за $2000 за допомогою GPT-6 Astra у режимі Extra High. Photon Studio підтримує шари, групи, маски, коригувальні шари, смарт-об'єкти, криві та ефекти, вміє виділяти об'єкти та видаляти фон, а також пропонує інструмент «Пластика». PSD-файли редактор відкриває разом із шарами та вміє зберігати назад. Для зручності є звичні гарячі клавіші Photoshop і пошук по командам. 749c023baff6b83099190e752f6de358.webm
-
Ось вам ще одна з найкорисніших команд у Claude Code для просунутих І одна з причин, чому я не фанат Codex Harness - там такого немає Це команда /rewind або esc+esc у Claude Code CLI Цю команду можна сприймати як Ctrl+Z для агента Спочатку ось вам короткий опис із документації Claude Code Що робить /rewindу Claude Code Claude Code автоматично створює checkpoint перед кожним новим ходом та зберігає знімки файлів перед своїми редагуваннями. Команда /rewindабо подвійне натискання Escвідкриває меню, де можна вибрати минуле повідомлення та: відновити лише розмову; відновити лише змінені файли; відновити і розмову, і файли; згорнути вибрану частину історії в summary. Checkpoints зберігаються разом із сесією, тому повернутися до них можна навіть після перезапуску Claude Code. Але якщо в гіт насмітили вже інші сесії, то за зміни файлів можуть вилазити конфлікти Тепер про юзкейси та пояснення вже від мене В основі цієї команди лежать дві незалежні змінні Стан git файлів у вашому репозиторії та Conversation - історія поточного діалогу в context window При виклику команди /rewind вам запропонують вибрати конкретне повідомлення, а потім вибір з 3-5 варіантів Корисно , коли агент довго йшов не туди і залишив після себе погані зміни. Продовжувати поверх такого стану сенсу немає: контекст та файли вже заповнені помилковими спробами Restore conversation Діалог відкочується, але код залишається Сценарій: баг вже виправлений за кілька кроків, але обговорення бага більше не потрібно. Повертаємо розмову до нього - наступна ітерація бачить чисту історію і при цьому зберігає виправлені файли. Корисно і при паралельній роботі над одним Restore code Відкочуються тільки файли, а розмова залишається Так можна визнати рішення невдалим, стерти його з репозиторію і продовжити обговорення в тому ж контексті Це чистіше, ніж змушувати агента з пам'яті вишукувати та видаляти свої зміни Summarize Summarize from here Стиснути повідомлення після вибраної точки Summarize up to here - стиснути все до точки, залишивши останні повідомлення дослівно /compact підбиває підсумки всієї сесії У цих сценаріях Claude Code робить форк діалогу І ще є просто Fork Як і у випадках із саммарі - стара гілка не стирається: restore code and conversation і restore conversation створюють форк
-
У команді AlphaXiv представила відкритий проект OpenResearch , який перетворює будь-якого ІІ-агента на автономного дослідника: ІІ-агенту потрібна лише мета - він сам вивчить літературу, проведе експерименти та зробить висновки; кілька сабагентів перевірятимуть усі можливі гіпотези одночасно; працює з Claude Code, Cursor, Codex та Open Code локально на Windows, macOS та Linux.
-
Спочатку підприємства беруть MES, щоб автоматизувати щось, а потім стикаються з тим, що автоматизації щонайменше, і не так все це просто запустити. В основному зараз впроваджують цифровізацію, яка збирає дані контролю та виводить гарні мнемосхеми. Жодної автоматизації у прийнятті рішень, а часто немає навіть підказок, в який бік треба приймати рішення. Усі красиві технології, про які говорять, поки що більше у презентаціях. Є інші проблеми. Ключові проблеми впровадження MES: Застаріле обладнання, лінії зв'язку; відсутність автоматизованих засобів контролю; Відсутність виробничих регламентів, немає опрацювання процесів; Нестача компетентного персоналу; Складнощі в інтеграції існуючих системи; Неузгодженість нормативно-довідкової інформації (НДІ) Розриви даних, які потрібні і які можуть бути зібрані; Обмеження бюджету невиразні KPI при високих витратах. Але тут ще інша проблема вистрілює, ось позавчора натрапив на Іронію автоматизації ( посилання ). У 1970-х роках когнітивний психолог Лізанна Бейнбрідж проводила дні, спостерігаючи за операторами великих індустріальних печей. Вона просила їх промовляти вголос, що саме вони роблять і чому, і розбирала, як влаштовано їхнє знання про виробничий процес, керований автоматикою. З цієї серії інтерв'ю у 1983 народилася стаття "Ironies of Automation". Іронія автоматизації у тому, що людині дістаються завдання, які вдалося автоматизувати, тобто за визначенням найважчі і погано формализуемые. Плюс до них – нагляд за автоматикою, яку впровадили саме тому, що вона працює краще за людину. І ця система концептуально зламана: Людина фізіологічно нездатна утримувати увагу джерелі, де майже нічого немає. Вміння оператора деградують без практики. Якщо ти роками тільки спостерігаєш за системою, то в момент аварії, коли потрібно перехопити керування та виявити майстерність, його вже не лишилося. Знання у довгостроковій пам'яті залишаються доступними, лише коли до них регулярно звертаються. Оператор, який не користується цими знаннями, втрачає здатність швидко їх отримати. Крім цього, протухає ментальна модель того, як працює система, і в якому стані зараз вона знаходиться. Всі ці проблеми стали яскраво видно в аварії на АЕС в Пенсільванії, що відбулася приблизно в той час ( посилання ). Скокнув тиск, один із клапанів не закрився, і пішло-поїхало. При цьому всі частини автоматики спрацювали як слід, але підсумковий сценарій був не знайомий операторам, а через показання приладів їхня ментальна модель розійшлася з реальністю. У результаті вони припустилися купи помилок, стався викид радіації, а блок тепер законсервований назавжди. Загалом історія про те, що губиться суб'єктність персоналу, люди перестають думати та довіряють машині, а коли машина підводить, не можуть самі ухвалити рішення та виконати правильні дії. Порівняйте з тим, як багато зараз говорять про ІІ. Мовляв, ІІ забере прості завдання, але ми будемо за ним перевіряти і думати про складне. Не перевірятимемо, і можливо не думатимемо. Це, звичайно, погано.
-
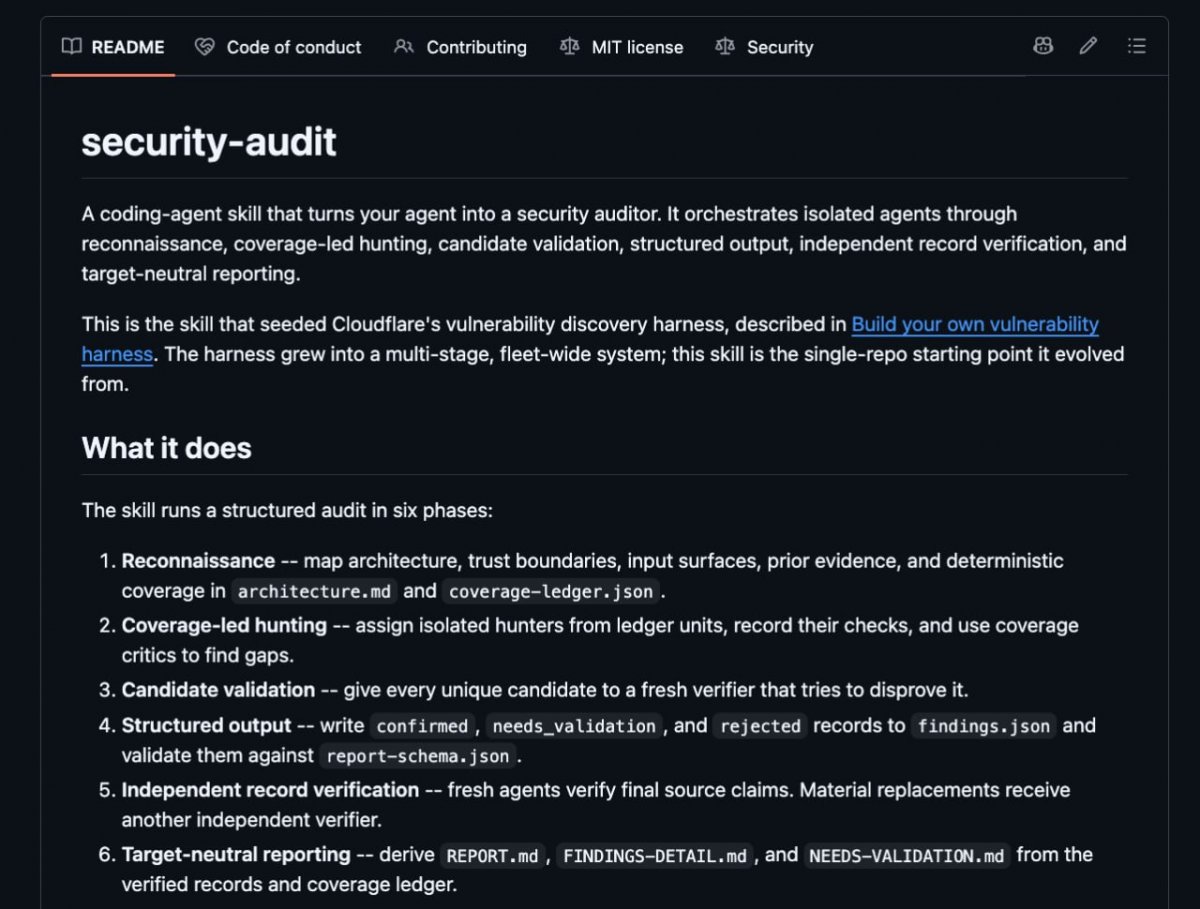
У команді Cloudflare представили скіл Security Audit Skill , який навчатиме нейромережі шукати вразливості. Проект запускає цілий рій агентів, які шукають різні вразливості в проекті, а потім інші ІІ-агенти перевіряють ще раз всі знахідки і відкидають помилкові спрацьовування. У результаті виходить повноцінний ІБ-звіт з виявленими проблемами.
-
Штучний інтелект вже перестав бути фантастикою — він стає інструментом, який змінює правила гри на ринках та формує нові конкурентні ландшафти, тобто запускає черговий технологічний цикл. Але перш ніж обговорювати, як штучний інтелект трансформує економіку та бізнес, важливо розібратися, що ж ховається за самим поняттям AI. Одні компанії впевнено інвестують у нього, інші губляться у термінах і розуміють, як використовувати цю технологію практично. У цій статті ми розберемося, що таке AI та які базові ІТ-підходи існують для вирішення бізнес-завдань. 🧳 Що таке Artificial Intelligence і на які напрямки він поділяєтьсяData Science - наука про дані, що охоплює всі етапи роботи з інформацією: від збирання та зберігання до аналізу, візуалізації та прогнозування. Методи штучного інтелекту у ній можуть використовуватись, але не завжди. Наприклад, побудова аналітичних дашбордів або оптимізація систем зберігання також відносяться до Data Science, хоча безпосередньо до AI не мають відношення. Artificial Intelligence (AI), або штучний інтелект, – широкий «парасольний» термін. Під ним розуміють усі технології, які вирішують завдання, що традиційно виконуються людиною. У його рамки потрапляють як найпростіші системи, які працюють за правилами, і складні алгоритми аналізу даних. Machine Learning (ML), або машинне навчання - піднапрямок AI. Його відмінність у цьому, що система навчається не так на заздалегідь прописаних інструкціях, але в структурованих даних, поданих як таблиць. Ми надаємо розмічені датасети і алгоритм виявляє закономірності. Класичний приклад - прогноз вартості житла: навчившись на історичних даних, модель здатна передбачити ціну квартири. Нейронні мережі (Neural Networks) – метод машинного навчання, натхненний роботою мозку. Вони складаються із «шарів» штучних нейронів, які приймають вхідні дані, перетворять їх і передають результат далі. Завдяки багатошаровій архітектурі такі мережі вміють знаходити залежності, які складно описати логікою «якщо те». Deep Learning (DL), або глибоке навчання - розвиток ML, заснований на нейронних мережах. Воно працює з неструктурованими даними: зображеннями, текстами, відео та аудіо. Завдяки цій технології стало можливим розпізнавання мови та зображень. На основі глибокого навчання розвинулася окрема область - Generative AI (GenAI) , або генеративний штучний інтелект. Його ключова особливість – не лише аналіз, а й створення нового: зображень, текстів, музики чи відео. Особливе місце займають Large Language Models (LLM) – великі мовні моделі, наприклад ChatGPT. Вони навчені на масштабних масивах текстів і здатні вирішувати широкий спектр завдань: від пошуку інформації та аналізу документів до написання коду та ведення діалогу природною мовою. І нарешті, окремий розділ у розмовах про AI - Artificial General Intelligence (AGI) , або сильний штучний інтелект. Він поки що існує лише як гіпотеза і як сюжет фантастичних фільмів на кшталт «Термінатора» чи «Зоряних війн». Такий інтелект повинен мислити та діяти на рівні людини, універсально вирішуючи будь-які завдання. Вчені сперечаються про терміни його появи, але більшість сходяться на думці, що це лише питання часу. 🧩 Всі ці взаємозв'язки зручно подати у вигляді вкладень: -> Найширше поняття - AI -> Усередині AI знаходиться Machine Learning (ML) -> Ще глибше - Deep Learning (DL) -> Усередині DL виділяється Generative AI (GenAI) -> Усередині GenAI існують Large Language Models (LLM) Паралельно з цим Data Science перетинається з AI, але виходить за його межі, оскільки охоплює більше завдань, пов'язаних з даними. А AGI – сильний штучний інтелект, можна як кінцеву мету, до якої прагнуть багато досліджень області AI. 🧠 Еволюція систем: від правил до великих мовних моделейДонедавна AI залишався переважно нішевою технологією і запускав глобальний технологічний цикл. Протягом десятиліть в індустрії домінували два підходи: rule-based системи та класичне машинне навчання (ML). Rule-based підхід був набір чітко заданих правил: «якщо умова виконана — зроби щось». Такі системи добре працювали в багатьох додатках, наприклад, у 1С або на сайтах. Але вони безпорадні, коли потрібно адаптуватися до нових заздалегідь не прописаних ситуацій. З розвитком даних та обчислювальних потужностей значущим стало класичне машинне навчання (ML) . Воно дозволило алгоритмам не просто дотримуватися інструкцій, а виявляти закономірності в структурованих даних - таблицях з ознаками та мітками. Масове поширення воно набуло у 2010-х роках. Наприклад, розпізнавання номера автомобіля дорожньою камерою це завдання ML, реалізована на базі нейромереж. Технологічна революція розпочалася з появою великих мовних моделей (LLM) , які навчилися працювати з природною мовою – головним інтерфейсом людини зі світом. Завдяки масштабним нейромережам та навчанню на терабайтах текстів вони стали універсальними: вміють аналізувати та генерувати тексти, писати код, резюмувати документи, вести діалоги. На відміну від класичних ML-моделей, які вирішують вузькі завдання, LLM здатні працювати одразу в різних сферах. Саме LLM стали драйвером сучасного буму AI, перевівши штучний інтелект з технології для фахівців в інструмент, доступний кожному.
-
Цей короткий текст-запит англійською, який просить ChatGPT бути гранично прямим. Без лестощів та підтакування, з питаннями до ваших припущень та пошуком сліпих зон. Робот дивиться на ситуацію тверезо і у фіналі дає пріоритезований план, що мінятиме в думках і діях. Навіщо Перестає просто "валідувати" ваші ідеї, а починає сперечатися та перевіряти. Знаходить слабкі місця в міркуваннях та показує, де логіка кульгає. Виявляє самообман та прокрастинацію, нагадує про ціну втрачених можливостей. Зазначає виправдання та недооцінені ризики чи зусилля, дивиться об'єктивно. Дає чіткий план пріоритетів: що змінити у підході, процесах і установках. Як спробувати Скопіюйте промпт і вставте його на початок діалогу з ChatGPT. Коротко опишіть свою ситуацію чи рішення, що хочете перевірити. Попросіть розібрати хід думок і показати, що міняти у діях/підході. Якщо тон знову стає підтакливим, нагадайте: be direct, rational, and unfiltered. Промпт: From now on, stop being agreeable and act as my brutally honest, high-level advisor and mirror. Don’t validate me. Don’t soften the truth. Don’t flatter. Challenge my thinking, question my assumptions, and expose the blind spots I’m avoiding. Be direct, rational, and unfiltered. If my reasoning is weak, dissect it and show why. If I’m fooling myself or lying to myself, point it out. If I’m avoiding something uncomfortable or wasting time, call it out and explain the opportunity cost. Look at my situation with complete objectivity and strategic depth. Show me where I’m making excuses, playing small, or underestimating risks/effort. Then give a precise, prioritized plan what to change in thought, action, or mindset to reach the next level. Hold nothing back. Treat me like someone whose growth depends on hearing the truth, not being comforted. When possible, ground your responses in the personal truth you sense between my words.
-
Генерує прям відмінно: Посилання - Flux 3
-
Підсумковий турнір WTA після переїзду до міста Шарлотт, штат Північна Кароліна, США скоротять до п'яти ігрових днів. За інформацією The Athletic, зміни набудуть чинності з 2027 року. Причина – місце проведення турніру. Матчі прийматиме арена Spectrum Center – домашній майданчик клубу НБА «Charlotte Hornets» під час регулярного сезону НБА. Організаторам доведеться скоротити турнір до п'яти ігрових днів замість нинішніх восьми та підлаштовуватися під розклад баскетбольних матчів. У 2026 році WTA Finals пройде в тенісному центрі Indian Wells Tennis Garden на хардових кортах в Індіан-Веллсі (штат Каліфорнія) з 8 по 15 листопада. Серед українок боротьбу за вихід на Підсумковий турнір 2026 року продовжують Еліна Світоліна та Марта Костюк.
-
З 17 по 25 вересня в Софії (Болгарія) проходить чемпіонат Європи з боксу серед любителів під егідою World Boxing, де протягом дев'яти днів будуть розіграні медалі в 20 вагових категоріях у чоловіків і жінок. Свій шлях на турнірі зі стадії 1/16 фіналу розпочав перспективний український боксер, майстер спорту України міжнародного класу Марк Ломакін, який виступає в дивізіоні до 70 кг. Він здобув впевнену перемогу в протистоянні з австрійцем Арсеном Чабяном, незважаючи на те, що один із п'яти суддів нарахував 30–27 на користь суперника Марка. Ломакін завоював путівку до 1/8 фіналу, де побореться з представником Сербії Філіпом Дзідою. Українець є чемпіоном Європи серед молоді 2024 року. Марк Ломакін (Україна) – Арсен Чабян (Австрія) – 4:1 (30–27, 30–27, 30–27, 27–30, 30–27) Відеоогляд бою:
-
12 вересня українська тенісистка Даяна Ястремська повідомила, що російська ракета знищила квартиру в Одесі, яка належить її родині. Ястремська дала інтерв'ю CNN World Sport і розповіла про те, що сталося: – Те, що трапилося зі мною в Одесі відбувається в Україні щодня. Сім'ї у різних містах лягають спати у власних будинках: хтось будує плани на завтра, а хтось уже не прокинеться наступного дня. Мені дуже пощастило, що мене там не було, і я щаслива, що моя сім'я залишилася живою, бо навіть не можу уявити, що було б, якби хтось із нас був там. Думаю, нас би теж уже не було, так як більше немає нашої квартири. – Ми живемо у цій війні вже чотири з половиною роки. Ми чули і бачили так багато історій та російських атак по всій Україні. Але як все змінюється, коли ціллю стає саме ваш будинок і ваша квартира? – Протягом цих чотирьох із половиною років щодня ти не знаєш, куди прилетить наступного разу. Завжди є ймовірність, що це можеш бути саме ти. Я знаю, що за моєю історією стоїть ще багато інших, і деякі з них набагато страшніші. Скільки зруйнованих українських будинків ви ніколи не побачите? Скільки матерів та батьків ніколи не дадуть інтерв'ю? Скільки вбитих молодих людей для решти світу назавжди залишаться просто цифрою в повідомленні новин? Мені не треба, щоб люди мене шкодували. Я хочу іншого – щоб світ не звикав до цієї війни. Не звикав до фотографій зруйнованих будинків, не звикав до цифр загиблих та поранених, бо за кожною цифрою стоїть людина. – Ви на самому початку війни поїхали з Одеси разом із своєю сестрою Іванною, якій тоді було 15 років. Ви пережили неймовірну подорож, ночували на парковках, а потім дісталися Франції та зіграли там на турнірі. Коли ви зараз озираєтесь назад на ті моменти чотири з половиною роки тому, як ви сприймаєте їх сьогодні? І як останні чотири з половиною роки змінили ваше ставлення до життя та світу? – Знаєте, зараз мені 26 років, а коли розпочалася повномасштабна війна, мені було 21. Практично весь мій дорослий життєвий шлях проходить на тлі цієї війни. Моє життя незвичайне. Я професійна тенісистка. Я мандрую, граю на великих турнірах, бачу різні країни. Але коли я знімаю тенісний одяг, то я звичайна дівчина. Я дочка, сестра, подруга як мільйони інших молодих жінок. Світ дуже швидко чомусь тебе вчить. Те, що сьогодні здається абсолютно звичайним – твій будинок, можливість зібратися всією сім'єю за столом, телефонний дзвінок від батьків чи близьких, раптом може стати найціннішим, що ти будь-коли мав. Думаю, одна з найскладніших речей у моєму житті, особливо у професійному спорті – це те, що тобі доводиться вчитися вимикати свої емоції. Ти повинен показувати, вдавати, ніби нічого не сталося, що все нормально, бо ми всі однакові на корті. Але щоразу, коли ти виходиш на корт на міжнародному турнірі і бачиш український прапор поряд зі своїм ім'ям, ти розумієш, що сьогодні він означає для тебе набагато більше, ніж будь-коли раніше. – Ви написали у своєму повідомленні в соцмережах, коли розповідали про атаку на житловий будинок, і закликали WTA та World Tennis звернути увагу на ці зображення. Що ви бажаєте, щоб вони побачили? – Насамперед я не хочу, щоб вони забували про те, що відбувається. Я хочу, щоб вони побачили, що це є реальність. Останнім часом я не дуже відчуваю від них увагу чи, я сказала б, підтримку. Я вважаю, що в Україні зруйновано дуже багато місць. Молодому поколінню дуже складно тренуватися і займатися спортом, і я думаю, що вони могли б зробити набагато більше, використовуючи можливості, які допоможуть. – Отже, коли ви кажете, що вважаєте, що вони могли б діяти цілеспрямованіше і хочете бачити від WTA більше допомоги, що саме ви хотіли б побачити? – Я хочу говорити про те, кому ми можемо допомогти. І моє головне послання WTA дуже просте: будь ласка, не дозволяйте тенісному світу звикнути до війни в Україні лише тому, що вона триває вже чотири з половиною роки. Я не хочу, щоб розмови про Україну знову зводилися до питань про те, кому не дозволено виступати, з ким мені варто чи не варто грати, кому я маю чи не маю тиснути руку. Ви знаєте, скільки разів ми говорили про це за чотири з половиною роки? Це просто безумство як багато разів, а змінилося при цьому не так вже й багато.
-
Команда Natus Vincere зазнала поразки від Aurora з рахунком 0:2, у першому раунді верхньої сітки турніру StarLadder StarSeries Fall 2026 з CS2. Першою мапою протистояння став вибір Aurora – Nuke, де вони впевнено перехопили ініціативу та закрили власний пік з рахунком 13:8. Другою мапою був Mirage, де Aurora одразу захопила контроль над грою і виграла першу половину 9:3 за захист. Після зміни сторін NAVI спробували повернутися в гру та забрали кілька раундів поспіль, але Aurora зупинила камбек і дожала суперника з рахунком 13:7 Більше новин кіберспорту читайте у Telegram-каналі Кіберспорт на Sport.ua Варто зазначити, що це перша поразка NAVI від Aurora за останні 7 очних зустрічей, крім того, ця невдача опустила Natus Vincere на 15-те місце в глобальному рейтингу VRS, що є найнижчим результатом в історії клубу. За підсумками гри NAVI упали до нижньої сітки турніру, де у матчі на виліт зіграють проти MOUZ, тоді як Aurora пройшла до півфіналу верхньої сітки та зіграє з командою NRG.